工具笔记
让 AI 读 PostgreSQL 执行计划,先核对行数偏差
找到第一个明显偏差,再决定要不要改索引。
资料核验2026.11.12 · PostgreSQL · 以部署版本文档为准
一条查询耗时高,计划里节点很多。先找估算和实际行数差距最大的早期节点。后面的连接方式可能只是建立在错误估算上的结果。
交给编码助手的任务
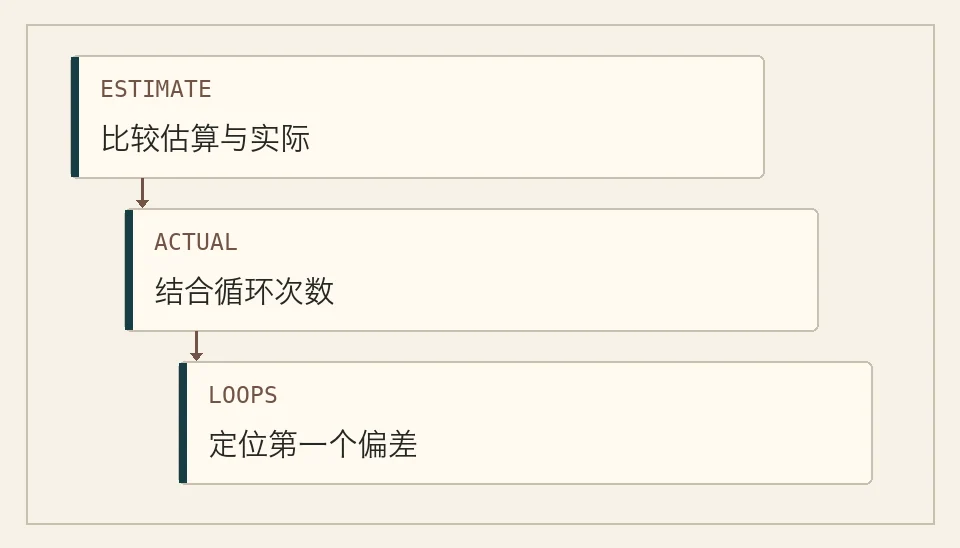
把脱敏的 EXPLAIN 输出和查询参数给助手,要求按树从早期节点标记估算行与实际行差异,解释 loops 对阅读的影响。让它提出一个可区分统计、数据倾斜和索引问题的检查。
用可重复的读查询做基线
对安全的 SELECT 使用 EXPLAIN (ANALYZE, BUFFERS),保留参数和样本规模。计划中的实际行数在循环节点上通常按每轮平均显示,要结合 loops 阅读。看见偏差时,先确认统计信息、筛选值和数据分布。
ANALYZE 会实际执行语句。对写入或带副作用的查询,应使用隔离环境验证。
如果建议加索引,让助手说清楚想改变哪个节点,再跑一次同条件计划确认效果。
先准备一个对照样例
读计划时可以先抄一行 rows=10、actual rows=120 loops=5。说明估算是该节点的计划值,实际行与循环要结合看。随后沿上游查哪个过滤条件最先出现偏差,并列出能复查的 SQL。
用这些结果验收
- 报告包含节点、估算值、实际值及循环次数。
- 复跑保留参数和数据规模。
- 优化后结果一致,计划变化能解释。
审查时容易漏掉什么
ANALYZE 会实际执行语句。对带副作用的语句在隔离环境跑,常规分析优先使用读查询。AI 从文本推断原因后,仍要用数据库里的数据分布或统计验证。
如果最早偏差出现在过滤节点,先核对谓词和参数类型。后续连接耗时可能只是传入行数超出预期的结果。建议让助手报告可反驳的假设,并用同一组数据重跑,而非只根据截图挑耗时最高的行。
在隔离数据上保存同一条 SQL 的前后两份计划。表名、列名和参数应替换为实际查询。
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at
FROM events
WHERE project_id = 42
ORDER BY created_at DESC
LIMIT 20;