发布与验证
让 AI 审静态发布边界:草稿不能靠 robots.txt 隐藏
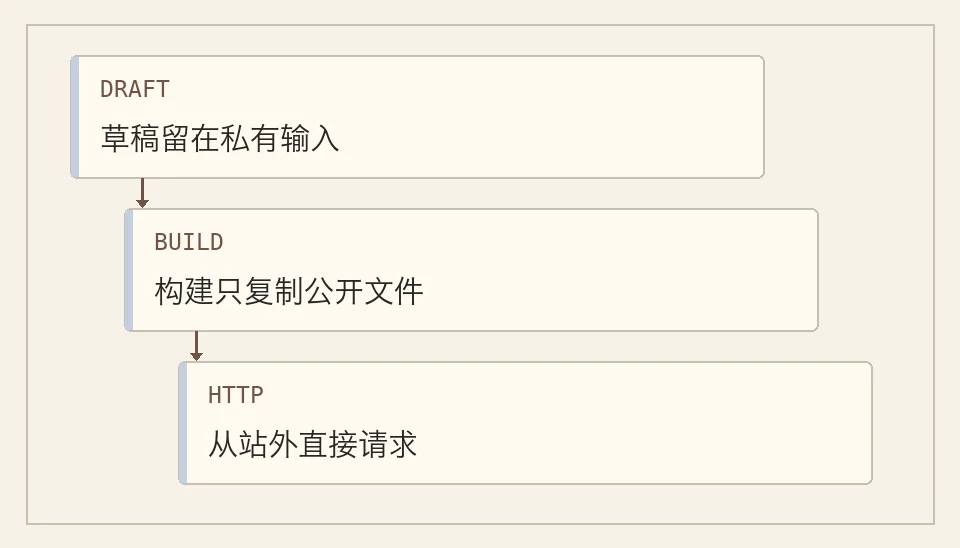
把私有内容留在公开构建目录之外。
资料核验2026.11.12 · 静态内容站 · RSS、索引与发布检查
有人在 robots.txt 里加一条禁止抓取草稿的规则,感觉就像给目录上了锁。实际只要静态文件仍在公开服务器,知道地址的人就能请求它。爬取规则不能替代访问控制。
给 AI 的上下文与边界
要求助手按实际部署目录检查草稿是否可能作为静态文件被读取。提供一条已知草稿 URL、公开 RSS、搜索索引和站点地图入口,让它使用未登录请求逐一核对。
验收时直接请求地址
将草稿和公开产物隔离,或在需要远程审阅时使用经过身份验证的入口。先生成一份站点产物,再直接访问草稿路径,检查返回状态与内容。还要搜站点地图、搜索索引和 RSS 是否包含草稿标题。
若某份内容曾经上线,撤下产物后检查托管缓存和公开链接。爬虫规则并不保证已知地址从搜索结果消失。
把隔离规则写在构建输入处,页面模板才无需到处判断某篇文章能不能公开。
可以直接照着做的演练
给草稿正文加一个唯一假标记。在无登录状态下直接请求候选草稿 URL,并到构建目录、RSS 和搜索索引检索标记。返回 404 和响应里没有正文是两项独立检查,正常公开文章还应能读取。
检查生成结果
- 草稿路径无法读到正文。
- 静态目录与三个公开索引不含草稿标题。
- 正常文章 URL 仍可读。需要远程审阅时,走有身份验证的入口。
复查时追问一层
robots.txt 约束爬虫访问意愿,不能保护静态服务器上的内容。真正的修复在构建输入和发布目录。如果草稿曾经公开,验证撤下后的实际响应,并检查缓存和已分享的链接。
也要检查托管服务是否把所有未知路径重写到公开首页。404 不是唯一可以讨论的状态,重点是未登录不能拿到草稿内容,且返回行为符合产品约定。若发现泄漏,先从发布输入排除草稿,再核对已生成与已部署的副本。